Définissez ce qu’est une réponse correcte
La génération augmentée par récupération (RAG) fournit au modèle des sources pertinentes avant qu’il ne réponde. Elle peut aider avec des connaissances privées ou changeantes, mais la récupération ne garantit pas que le contenu récupéré soit exact, complet ou autorisé pour l’utilisateur.
Commencez par un cas d’usage restreint, comme répondre aux questions sur un manuel produit versionné. Rédigez des exemples de réponses acceptables, les citations nécessaires et les cas où le système doit refuser de répondre ou transmettre la demande. Séparez la génération des réponses des outils qui modifient les données métier.
Préparez les documents pour la récupération
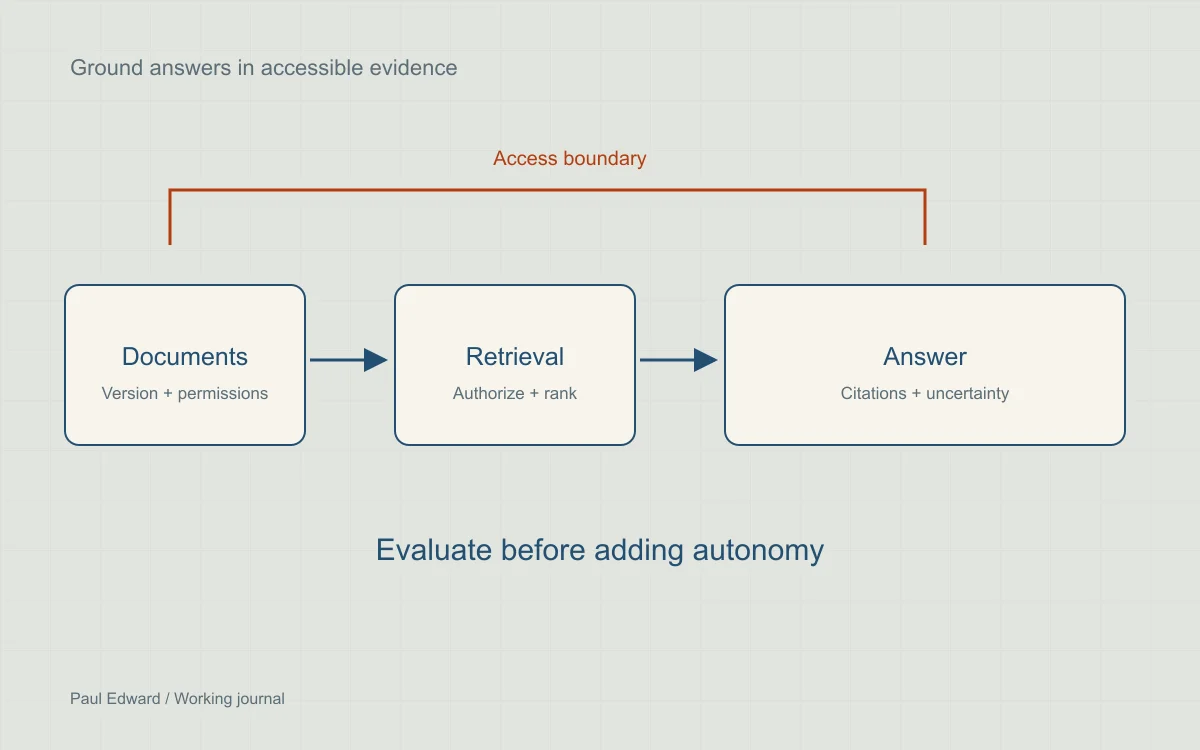
Conservez les titres, le contexte des tableaux, les numéros de version et les URL sources. Attribuez à chaque fragment un identifiant de document stable et conservez ses règles d’accès et sa date de révision. Découpez selon des frontières sémantiques utiles au lieu de supposer qu’un même nombre de tokens convient à tous les documents. Testez des questions dont la réponse couvre deux sections ou dépend d’une note de bas de page.
Les suppressions de documents et les changements de permissions doivent se propager aux index de recherche et aux caches. Recalculer les embeddings d’un document ne doit pas laisser derrière lui d’anciens fragments accessibles. Gardez une trace des échecs d’ingestion pour que les opérateurs voient quelles preuves manquent.
Comparez les approches de récupération
Les termes exacts, comme les codes d’erreur, les références produit et les numéros de version, gagnent souvent à passer par une recherche par mots-clés. Les embeddings peuvent aider pour la similarité conceptuelle. Un système hybride peut combiner les deux ensembles de résultats et utiliser la fusion de classements ou le reclassement, mais il ajoute du coût et de la latence.
Constituez un jeu de questions annotées avant d’ajouter des étapes. Mesurez si les passages pertinents et autorisés figurent dans l’ensemble récupéré, puis si la réponse finale s’appuie sur ces passages. Incluez des questions ambiguës, sans réponse et obsolètes. La précision à un seuil donné est une mesure de récupération, pas une mesure de l’exactitude factuelle globale.
Appliquez le contrôle d’accès avant d’exposer le contexte
- Authentifiez l’utilisateur et établissez les permissions par client et par document dans un code applicatif de confiance.
- Appliquez les contraintes d’autorisation à la récupération et validez les passages finalement retenus avant qu’ils n’atteignent le modèle.
- Traitez le texte récupéré comme une donnée non fiable. Une instruction contenue dans un document demandant de révéler des secrets ou d’appeler un outil ne doit pas l’emporter sur la politique de l’application.
- Limitez les outils aux opérations nécessaires ; validez les arguments, les permissions et les règles métier indépendamment de la sortie du modèle.
- Exigez une étape de confirmation ou de relecture adaptée pour les actions lourdes de conséquences et conservez une piste d’audit minimale.
Maîtrisez les coûts sans servir la mauvaise réponse
Suivez séparément les coûts de récupération, d’embeddings, de reclassement et de génération, ainsi que la latence p50 et p95. Limitez le contexte aux passages utiles pour répondre, plafonnez la longueur de la sortie et choisissez la capacité du modèle en fonction de votre jeu d’évaluation.
Commencez le cache par des correspondances exactes et une stratégie d’invalidation claire. Délimitez les clés par client, version de la politique d’accès, version du document, modèle et version du prompt. Une formulation similaire ne suffit pas à établir que deux utilisateurs ont droit à la même réponse. Un cache sémantique exige des tests supplémentaires contre les fausses correspondances et les réponses périmées ; il implique toujours un travail de récupération ou d’embeddings.
Mettez en production avec un seuil d’acceptation mesurable
Fixez des seuils adaptés au risque du cas d’usage. Testez les citations, les refus, les limites de permissions, les documents malveillants, les délais dépassés et les échecs d’outils. Un JSON structuré peut fiabiliser l’analyse, mais un schéma valide ne rend ni une affirmation vraie ni une action autorisée.
Examinez les réponses erronées et les échecs de récupération après la mise en production. Ajoutez-les à un jeu de non-régression réservé plutôt que d’optimiser uniquement pour une démonstration. Montrez à l’utilisateur la source qui étaye la réponse et rendez l’incertitude visible lorsque les documents disponibles ne permettent pas de trancher.
Questions fréquentes
Le RAG empêche-t-il un système d’IA d’inventer des réponses ?
Non. La récupération peut apporter des éléments utiles, mais les passages peuvent être incomplets, obsolètes ou hors sujet, et le modèle peut les mal interpréter. Évaluez si la réponse finale s’appuie sur les sources retenues et définissez quand le système doit refuser de répondre ou transmettre la demande.
Comment empêcher un client de voir les documents d’un autre client ?
Appliquez les permissions par client et par document dans un code applicatif de confiance avant que les éléments n’atteignent le modèle. Revérifiez les passages retenus et délimitez les caches selon la politique d’accès et les versions de contenu concernées. Un prompt demandant au modèle de respecter les permissions n’est pas une barrière d’autorisation.
Faut-il utiliser la recherche par mots-clés, la recherche vectorielle ou les deux ?
Testez d’abord des questions représentatives. Les identifiants exacts et les codes d’erreur nécessitent souvent une correspondance par mots-clés, tandis que les embeddings peuvent aider pour la similarité conceptuelle. Comparez la qualité de récupération, l’étayage des réponses, la latence et le coût avant d’ajouter une récupération hybride ou un reclassement.
Quand est-il sûr de mettre en cache une réponse d’IA ?
Uniquement lorsque la clé de cache et les règles d’invalidation préservent les exigences de permissions et de fraîcheur de la réponse. Incluez les versions du client, de la politique, du document, du modèle et du prompt lorsque c’est pertinent. Une formulation proche ne prouve pas à elle seule que deux utilisateurs peuvent recevoir la même réponse.
Sources et lectures complémentaires
Pour aller plus loin
Découvrez le développement d’applications d’IA ou le guide des files d’attente et de l’idempotence pour des traitements en arrière-plan fiables.
Leave a Reply