先定义什么是正确的回答
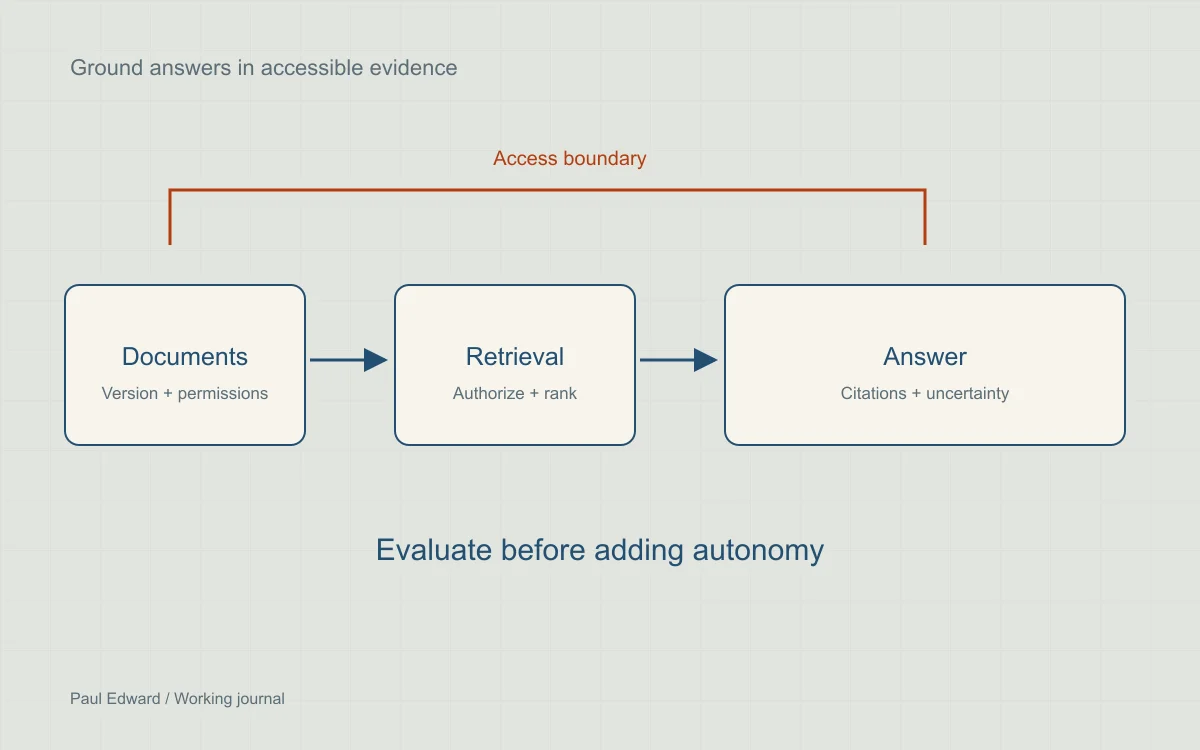
检索增强生成(RAG)会在模型作答之前,为它提供相关的原始资料。它有助于处理不断变化或非公开的知识,但检索并不能保证取回的资料是正确、完整的,也不能保证该用户有权查看。
从一个范围较窄的用例开始,例如回答有版本区分的产品手册相关问题。写下可接受回答的示例、它们需要的引用,以及系统何时应拒绝回答或转交人工。把回答生成与会修改业务记录的工具分开。
为检索准备文档
保留标题、表格上下文、版本号和来源 URL。为每个文本块分配稳定的文档标识,并保留其访问规则和修订日期。按有意义的语义边界切分,而不是假设同一个 token 数量适用于所有文档。测试那些答案横跨两个章节或取决于脚注的问题。
文档删除和权限变更必须同步到搜索索引和缓存。重新生成文档的向量时,不能遗留旧的、仍可访问的文本块。记录导入失败的情况,让运维人员能看到缺少了哪些证据。
比较不同的检索方式
错误代码、SKU 和版本号等精确词语,通常更适合关键词检索。向量嵌入则有助于处理概念上的相似性。混合系统可以合并两组结果,并使用排名融合或重排序,但会增加成本和延迟。
在增加处理环节之前,先建立一组带标注的问题集。衡量相关且有权访问的段落是否出现在检索结果中,再看最终回答是否有这些段落作为依据。问题集中应包含含糊的、无法回答的和已过时的问题。某个截断位置的精确率是检索指标,而不是整体事实准确性的衡量标准。
在暴露上下文之前执行访问控制
- 在可信的应用代码中对用户进行身份验证,并确定租户和文档权限。
- 在检索时应用授权约束,并在最终选定的段落送入模型之前再次校验。
- 把检索到的文本视为不可信数据。文档中要求泄露机密或调用工具的指令,不能凌驾于应用策略之上。
- 把工具限制在必要的操作范围内;独立于模型输出,校验参数、权限和业务规则。
- 对有重大影响的操作要求适当的确认或审核步骤,并保留最基本的审计记录。
控制成本,但不以给出错误答案为代价
分别跟踪检索、向量化、重排序和生成的成本,以及 p50 和 p95 延迟。把上下文限定在有助于回答问题的段落上,限制输出长度,并根据评估集选择合适的模型能力。
缓存先从精确匹配和清晰的失效策略做起。缓存键应按租户、访问策略版本、文档版本、模型和提示词版本进行区分。措辞相似并不足以说明两个用户有权获得同一个回答。语义缓存需要额外测试误匹配和过时回答的情况,而且它仍然需要进行检索或向量化处理。
以可衡量的验收标准发布
根据用例的风险设定阈值。测试引用、拒答、权限边界、恶意文档、超时和工具故障。结构化 JSON 可以让解析更可靠,但结构合法并不意味着陈述为真,也不意味着操作已获授权。
发布后复盘错误回答和检索遗漏的情况。把它们加入预留的回归测试集,而不是只针对演示效果进行调优。向用户展示支撑回答的来源;当现有资料无法解决问题时,要明确表达不确定性。
常见问题
RAG 能阻止 AI 系统编造答案吗?
不能。检索可以提供有用的证据,但段落可能不完整、已过时或不相关,模型也可能误解它们。请评估最终回答是否有选定来源作为依据,并定义系统何时应拒绝回答或转交人工。
如何防止一个客户看到另一个客户的文档?
在证据送入模型之前,于可信的应用代码中执行租户和文档权限控制。再次核对选定的段落,并按相应的访问策略和内容版本划分缓存。要求模型遵守权限的提示词,并不是授权边界。
应该使用关键词检索、向量检索,还是两者结合?
先用有代表性的问题进行测试。精确的标识符和错误代码往往需要关键词匹配,而向量嵌入有助于处理概念相似性。在引入混合检索或重排序之前,比较检索质量、回答依据、延迟和成本。
什么时候缓存 AI 回答是安全的?
只有当缓存键和失效规则能够保持回答的权限要求和时效要求时才安全。在相关情况下,要把租户、策略、文档、模型和提示词的版本纳入缓存键。仅凭措辞相似,并不能证明两个用户可以得到同一个回答。
Leave a Reply