从公开且可索引的页面开始
托管在本地的开发网站无法被公共搜索引擎发现。在公开域名上,请确认目标文章无需登录即可返回成功响应,所需资源可以正常获取,并且页面标记和 HTTP 响应头中都没有意外的 noindex 指令。
robots.txt 控制抓取;noindex 在抓取工具能够读取时控制索引。在 robots.txt 中屏蔽某个 URL,并不是从搜索结果中移除它的可靠方法。请保护好预发布环境,并把上线检查明确列为步骤。
为每篇文章设定一个首选 URL
使用稳定的固定链接,并在导航、相关文章、站点地图和元数据中一致地链接到它。把过时的别名重定向到合适的目标地址,而不是在多个路径上提供完全相同的内容。规范标签是一种信号而非命令,应当与页面内容和其他信号保持一致。
对于已删除且没有同等替代页面的内容,要返回真正的 404 或 410。不要仅仅因为 URL 以熟悉的别名结尾,就返回一篇通用文章并给出成功响应。为分页的归档页提供各自的 URL,并保持其链接可被抓取。
围绕读者的任务组织内容
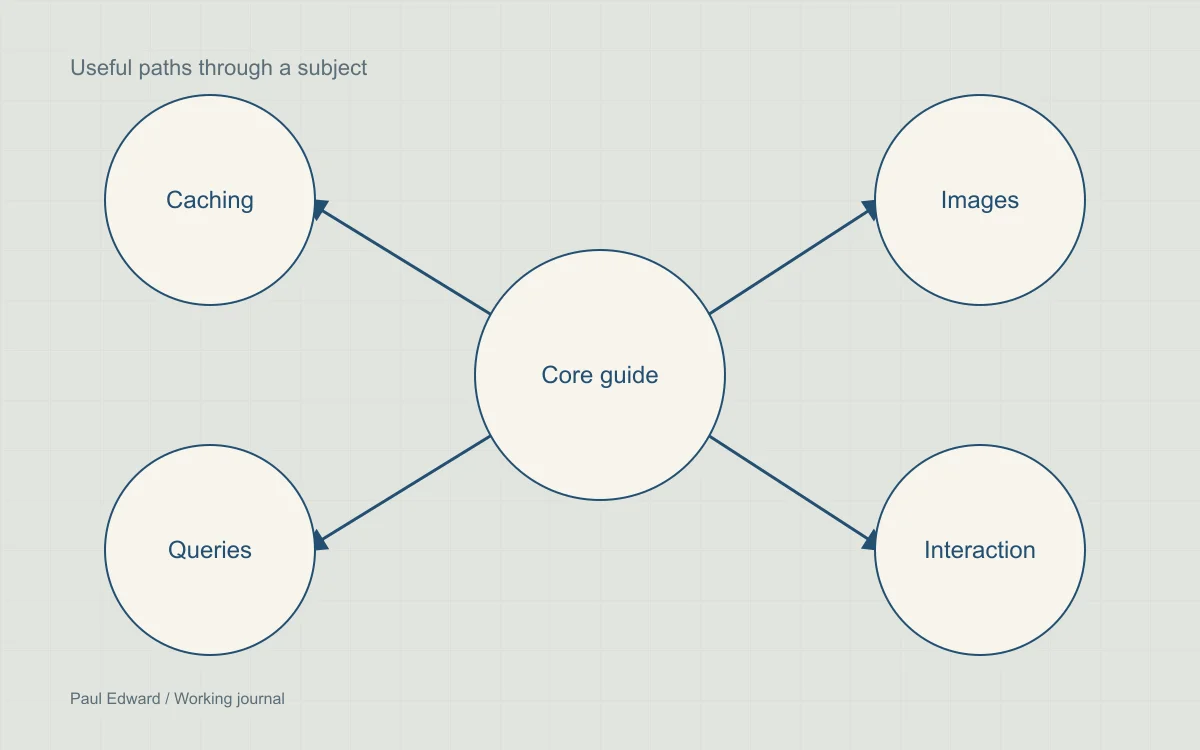
创建一篇能帮助读者选择下一步的指南,再链接到相关的详细文章。例如,WordPress 提速检查清单可以链接到服务器响应诊断和响应式图片。那些文章在需要更完整的清单时,也可以链回来。
使用描述性的链接文字和普通的 HTML 锚点。并不存在必须达到的字数、主题集群规模或链接数量,能让页面成为权威。避免创建几乎重复、只针对同一问题略有不同说法的页面。
让搜索和分享元数据保持准确
- 撰写独特的标题,描述文章实际解决的任务或给出的答案。
- 在元描述中概括页面内容,不要做没有依据的承诺。搜索引擎可能会选择其他摘要。
- 使用合适的社交分享图片、有意义的替代文本和正确的图片尺寸。
- 让作者身份以及发布和更新日期清晰可见,并与已保存的内容一致。
- 为文章使用 Article 或 BlogPosting 结构化数据,并配以对应的面包屑导航。不要添加页面无法证实的评分、奖项或声明。
让发现类文件保持精简
在 XML 站点地图中收录规范、公开且可索引的文章。排除非公开内容和有意设为 noindex 的文章。站点地图有助于发现,但提交站点地图并不能保证每个 URL 都会被编入索引。
小型内容网站很少需要复杂的抓取预算调控。在屏蔽有用的分类之前,先修复失效的内部链接、重复的 URL 模式和服务器错误。站内搜索结果页可以设为 noindex,同时保持文章和分类链接可以访问。
这对 AI 搜索有什么帮助?
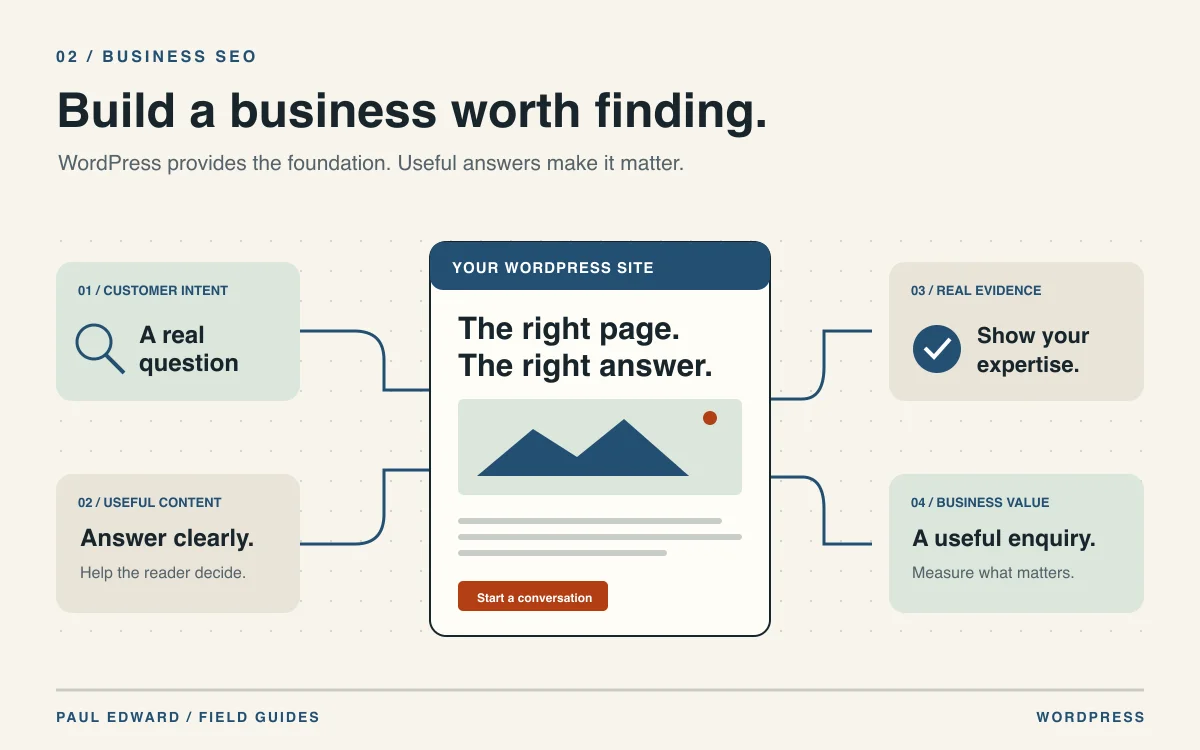
清晰的回答、可访问的 HTML、支持性的证据和准确的署名,同样有助于系统理解页面。Google 关于 AI 搜索的指南并不要求特殊的 AI 结构化数据或 AI 文本文件。简洁的 llms.txt 可以作为辅助导航,但并不能保证被索引或被引用。
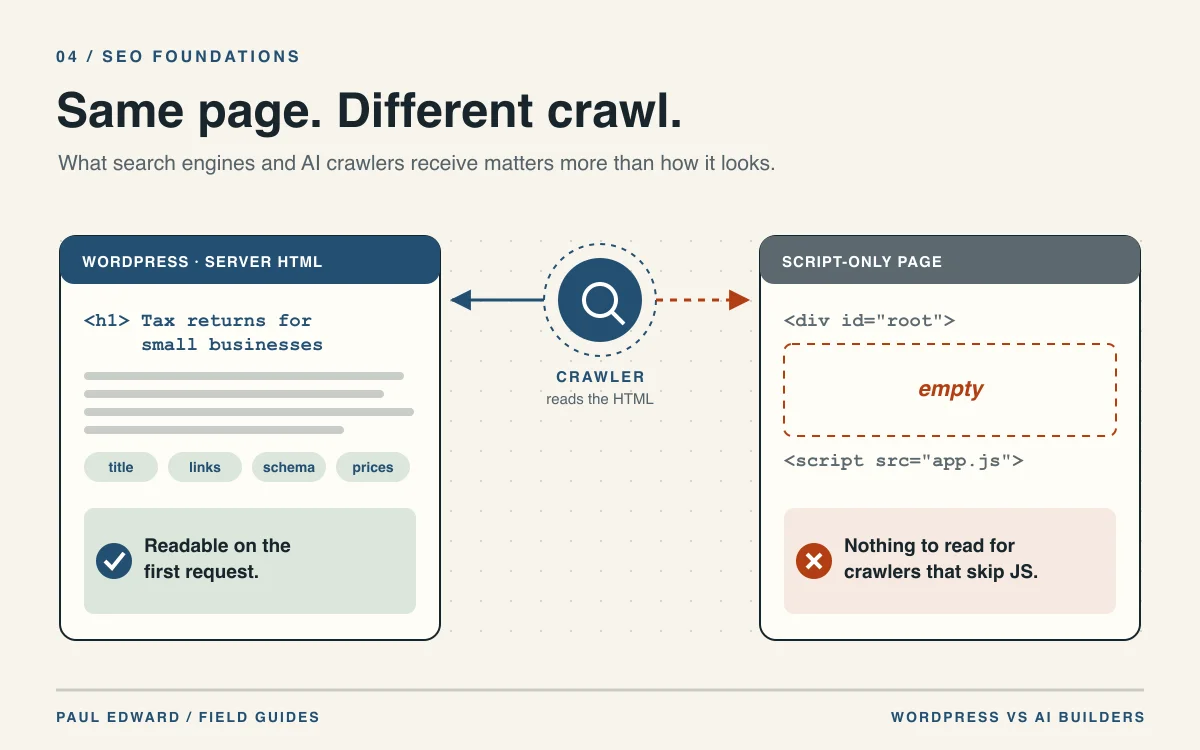
检查公开主机以及任何 CDN 或防火墙上的抓取工具访问情况。不要制作只给机器人看的内容,也不要在隐藏内容中堆砌重复的关键词。有用的回答应该与读者看到的内容完全一致。
在公开域名上衡量进展
在 Search Console 和 Bing Webmaster Tools 中验证网站,提交站点地图,并检查有代表性的 URL。在可比较的时间段内,跟踪索引情况、相关查询、展示次数、点击次数和有效咨询。区分品牌词和非品牌词的需求,并标注每次发布。单凭排名变化,无法证明是哪项改动造成的。
常见问题
Google 能索引只运行在 .local 域名上的网站吗?
公共抓取工具无法访问只存在于你本地电脑上的网站。请把网站发布到可访问的域名上,然后检查 HTTPS、响应码、抓取权限、规范网址和索引指令。本地测试只能验证实现,而不能验证公开索引。
提交站点地图就能保证每篇文章都被索引吗?
不能。站点地图帮助搜索引擎发现首选 URL,但并不强制它们索引或排名这些 URL。请收录响应成功、公开且可索引的 URL,并在服务商的站长工具中检查已提交的站点地图和有代表性的页面。
要让页面不出现在搜索结果中,应该用 robots.txt 还是 noindex?
robots.txt 控制是否获取页面;noindex 则在抓取工具能读取到该指令后请求将页面排除。robots.txt 的屏蔽可能让抓取工具根本看不到 noindex。对于非公开内容,请使用身份验证,而不是把任何一种指令当作访问控制机制。
AI 搜索需要专门的 AI 文件或 FAQ 标记吗?
Google 表示不需要任何专门的 AI 文件或结构化数据,并且在搜索中会忽略 llms.txt。请专注于可访问、有用的内容和准确的技术输出。在 Search Console 中核实公开资源当前的资格设置;任何标记都无法保证被 AI 引用。请参阅官方 AI 优化指南。
Leave a Reply