Partez d’une page publique et indexable
Un site de développement hébergé en local ne peut pas être découvert par les moteurs de recherche publics. Sur le domaine public, vérifiez que les articles prévus renvoient une réponse réussie sans connexion, que les ressources nécessaires peuvent être récupérées et que ni le balisage de la page ni les en-têtes HTTP ne contiennent de directive noindex accidentelle.
Le fichier robots.txt contrôle l’exploration ; noindex contrôle l’indexation lorsqu’un robot peut le lire. Bloquer une URL dans robots.txt n’est pas un moyen fiable de la retirer des résultats. Gardez les environnements de préproduction protégés et rendez explicites les vérifications de mise en ligne.
Donnez à chaque article une seule URL préférée
Utilisez un permalien stable et reliez-y de façon cohérente la navigation, les articles associés, le sitemap et les métadonnées. Redirigez les alias obsolètes vers la bonne destination au lieu de servir un contenu identique à plusieurs adresses. Une balise canonique est un signal, pas un ordre, et elle doit concorder avec le contenu de la page et les autres signaux.
Renvoyez une vraie erreur 404 ou 410 pour les pages supprimées sans remplacement équivalent. Ne renvoyez pas une réponse réussie avec un article générique simplement parce que l’URL se termine par un slug familier. Donnez aux archives paginées leurs propres URL et gardez leurs liens explorables.
Organisez le contenu autour des besoins du lecteur
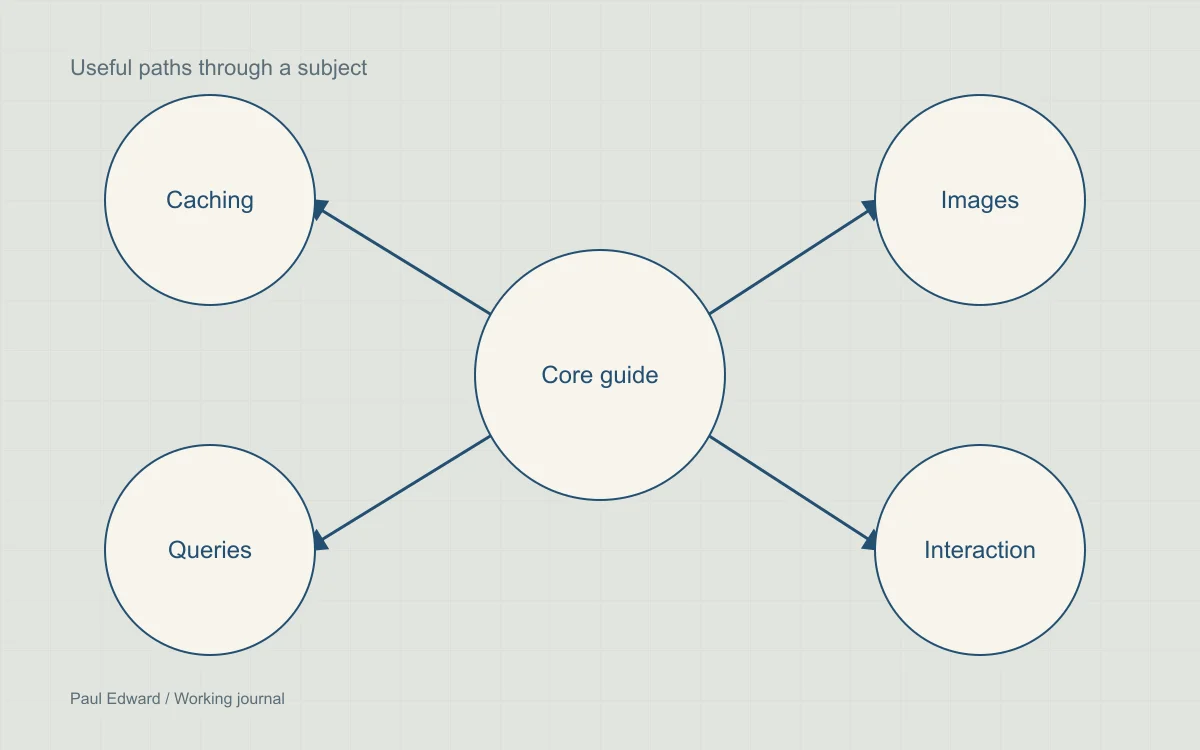
Créez un guide qui aide le lecteur à choisir l’étape suivante, puis renvoyez vers les articles détaillés pertinents. Par exemple, une checklist de vitesse WordPress peut renvoyer vers le diagnostic de la réponse serveur et vers les images responsives. Ces articles peuvent pointer en retour vers la checklist quand elle est utile.
Utilisez des textes de lien descriptifs et des ancres HTML ordinaires. Aucun nombre de mots, aucune taille de cluster ni aucun nombre de liens n’est requis pour faire d’une page une référence. Évitez les pages quasi identiques qui ciblent des variantes à peine différentes de la même question.
Soignez l’exactitude des métadonnées de recherche et de partage
- Rédigez un titre distinct qui décrit la tâche ou la réponse réelle de l’article.
- Résumez la page dans sa méta-description sans promesses infondées. Les moteurs peuvent choisir un autre extrait.
- Utilisez une image de partage adaptée, un texte alternatif pertinent et des dimensions d’image correctes.
- Gardez l’identité de l’auteur et les dates de publication et de mise à jour visibles et cohérentes avec le contenu enregistré.
- Utilisez les données structurées Article ou BlogPosting pour les articles, avec un fil d’Ariane correspondant. N’ajoutez pas de notes, de récompenses ni d’affirmations que la page ne justifie pas.
Gardez les fichiers de découverte ciblés
Incluez dans le sitemap XML les articles canoniques, publics et indexables. Excluez les contenus privés et les articles volontairement en noindex. Les sitemaps facilitent la découverte ; en soumettre un ne garantit pas l’indexation de chaque URL.
Un petit site éditorial a rarement besoin de manipulations élaborées du budget d’exploration. Corrigez les liens internes cassés, les schémas d’URL dupliqués et les erreurs serveur avant de bloquer des catégories utiles. Les pages de résultats de recherche peuvent être en noindex tandis que les liens vers les articles et catégories restent accessibles.
En quoi cela aide-t-il la recherche par IA ?
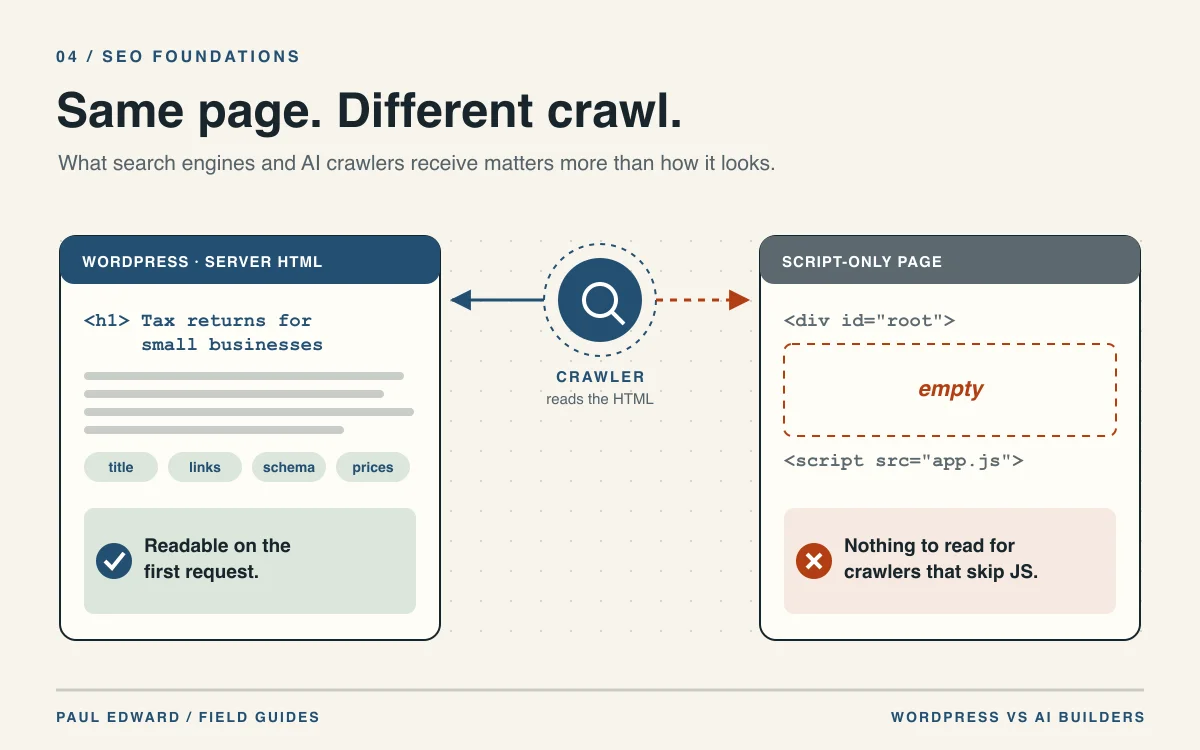
Des réponses claires, un HTML accessible, des preuves à l’appui et une attribution exacte aident aussi les systèmes à comprendre une page. Les consignes de Google sur la recherche par IA n’exigent ni schéma spécial pour l’IA ni fichier texte dédié. Un llms.txt concis peut servir d’aide complémentaire à la navigation, mais il ne garantit ni l’indexation ni les citations.
Vérifiez l’accès des robots sur l’hôte public et sur tout CDN ou pare-feu. Évitez de créer des affirmations réservées aux robots ou de bourrer du contenu masqué de mots-clés répétés. Une réponse utile doit être la même que celle que voit le lecteur.
Mesurez les progrès sur le domaine public
Validez le site dans la Search Console et dans Bing Webmaster Tools, soumettez le sitemap et inspectez des URL représentatives. Suivez l’indexation, les requêtes pertinentes, les impressions, les clics et les demandes utiles sur des périodes comparables. Séparez la demande de marque de la demande hors marque et annotez les mises en production. Un mouvement de classement ne prouve pas à lui seul quel changement l’a provoqué.
Questions fréquentes
Google peut-il indexer un site qui ne tourne que sur un domaine .local ?
Aucun robot public ne peut atteindre un site qui n’existe que sur votre machine locale. Publiez le site sur un domaine accessible, puis vérifiez le HTTPS, les codes de réponse, l’accès à l’exploration, les URL canoniques et les directives d’indexation. Les tests en local valident l’implémentation, pas l’indexation publique.
Soumettre un sitemap garantit-il l’indexation de chaque article ?
Non. Un sitemap aide un moteur à découvrir les URL préférées ; il ne l’oblige pas à les indexer ni à les classer. Incluez des URL publiques, indexables et qui répondent correctement, et examinez le sitemap soumis ainsi que des pages représentatives dans les outils pour webmasters du fournisseur.
Faut-il utiliser robots.txt ou noindex pour exclure une page des résultats ?
Le fichier robots.txt contrôle la récupération ; noindex demande l’exclusion une fois qu’un robot peut lire cette directive. Un blocage dans robots.txt peut empêcher le robot de voir le noindex. Protégez les contenus privés par une authentification au lieu de traiter l’une ou l’autre directive comme un mécanisme de contrôle d’accès.
Des fichiers spéciaux pour l’IA ou un balisage FAQ sont-ils nécessaires pour la recherche par IA ?
Google indique qu’aucun fichier ni schéma spécial n’est nécessaire, et qu’il ignore llms.txt pour la recherche. Concentrez-vous sur un contenu utile et accessible et sur une sortie technique exacte. Vérifiez les réglages d’éligibilité actuels de la propriété publique dans la Search Console ; aucun balisage ne garantit une citation par l’IA. Consultez le guide officiel d’optimisation pour l’IA.
Sources et lectures complémentaires
- Google : guide de démarrage SEO
- Google : consignes sur les URL canoniques
- Google : les fonctionnalités d’IA et votre site web
Pour aller plus loin
Lisez ce que Google documente sur le classement et la checklist de performance WordPress.
Leave a Reply